一度きりの答えより、数を集めた答え
新しい事業案のどちらを選ぶか、生成AIに聞いてみる。いちばん性能の高いモデルに一度尋ねれば、それなりの答えが返ってくる。そう考えている人は多いはずです。ところが、一度きりの答えは、案を並べる順番を入れ替えただけで変わることがありました。
ユニバーシティ・カレッジ・ロンドンのアニル・ドーシ先生らは、論文「Generative artificial intelligence and evaluating strategic decisions」で、生成AIが事業案をどこまで評価できるかを確かめました。実験は2023年末から2024年にかけて、GPT-4やClaude 2、Geminiなど当時のモデルで行われています。
調べ方は、事業案を二つずつ並べて「どちらが成功しそうか」を答えさせ、その結果を人間の評価と突き合わせるものです。一つ目の研究では、生成AIに10業種の事業案を60個書かせました。これを7種類のAIに、創業者、投資家、顧客、新聞記者など10通りの立場を演じさせ、2通りの聞き方で評価させています。使えた評価は3万7878件です。比べる相手は、戦略論の教授51人と、一般の社会人136人の判断でした。
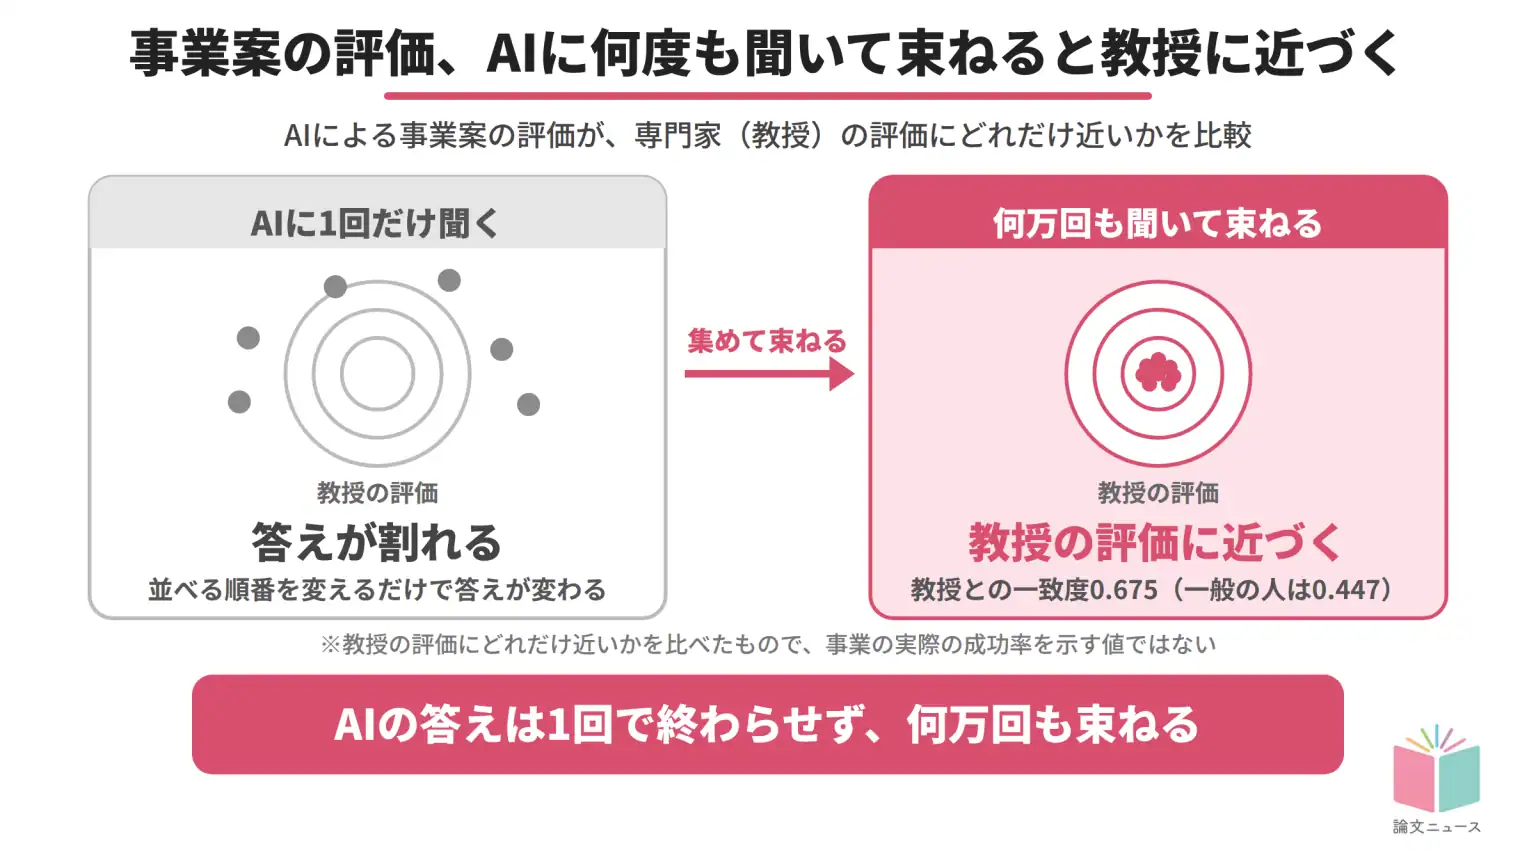
まず、一度ごとの答えは不安定でした。同じ2案を順番を入れ替えて聞くと、同じ答えが返ってきた割合は、いちばん高いモデルと聞き方の組み合わせでも80.9%で、42.2%にとどまる組み合わせもありました。後ろに置かれた案を83.5%の割合で選ぶモデルもありました。
ところが、答えを大量に集めて平均すると、姿が変わります。全評価をまとめ、各案が選ばれた割合を出すと、教授たちの評価との相関は0.675でした。一般の社会人は0.447です。業種ごとの最良の案を教授と同じく選べたのは10業種中5業種で、一般の社会人の2業種を上回りました。最も見込みの薄い案は10業種中6業種で一致しています。
専門家の評価に近づけたのは、AIや立場の種類を増やすことより、集める件数を増やすことでした。件数が同じまま種類を混ぜても改善は3〜8%にとどまり、件数を増やすとさらに6〜45%改善しました。
二つ目の研究では、2016年に米国の大学が開いた、賞金総額100万ドルのコンテストに実在のスタートアップが応募した事業案60件を使いました。6種類のAIで3万5975件の評価を集めると、審査員70人の採点との相関は0.663で、一つ目とほぼ同じ傾向が出ています。
ただし、比べたのは専門家の評価との一致で、事業が実際に成功したかではありません。結果は研究時点のAIの力を映したもので、モデルが進めば変わりうる、と先生らは述べています。
一度で決めず、数を集めて人と重ねる
事業の選択や投資の判断に、生成AIを使い始めた職場も多いでしょう。ただし、ここまでの結果は2023〜24年のAIで確かめられたものです。論文も、モデルが進めば一度ずつの答えは安定していくと見込む一方、見分けにくい判断ではぶれが残り、数を集める意味は続くとしています。以下は、研究時点で考えられる三つの手がかりです。
並べる順番を入れ替えて、聞き直す
AIは、同じ2案でも並べ方で答えを変えることがありました。A案とB案を比べさせたら、次はB案を先に書いて同じことを聞く。答えが入れ替わるなら、その判断はまだ当てにならないと見てよいはずです。
立場と聞き方を変えて、何度も集める
改善をもたらしたのは、評価の数でした。顧客なら、投資家なら、仕入先ならと立場を変え、聞き方も変えながら何十回と答えを集め、どちらが多く選ばれたかを数える。論文では、こうして数万件を集めた評価が専門家の見方に近づきました。立場を変えるのは答えに幅を持たせるためで、当たる立場を探すためではありません。最もよく一致した立場は、二つの研究で違っていました。
最後は、人の判断と重ねる
AIの評価が近づいたのは、あくまで専門家の見立てでした。実際に成功するかどうかは、また別の問題です。論文も、AIの評価は人の判断と組み合わせて使えるものとしています。会議の前にAIで大まかな順位をつけ、議論は上位と下位の案に時間を割く。そうした使い方が考えられます。
一度の答えはぶれても、数を重ねれば、ぶれは打ち消し合う。人の判断を集めるときと同じ理屈が、AIにも通じていました。問われているのは、どのAIを選ぶかより、何回聞くかなのかもしれません。